Phase 1 · Day 02 | 초기 구축 및 업무 자동화
지난 Day 01에서 전장설계 실무의 반복적인 일정 확인과 기술지원(AS·영업 대응) 현황 파악을 돕는 AI 비서, EVA(Electrical Virtual Assistant)의 큰 그림을 구상했다. 아이디어를 머릿속에 그리는 일은 즐거웠지만, 막상 키보드 앞에 앉아 첫 단추를 끼우려니 생각보다 현실적인 질문들이 먼저 쏟아졌다.
“이 자동화 도구를 도대체 어디에 띄워야 하지?”, “사내 업무 데이터를 외부 클라우드 서비스에 올려도 괜찮을까?”, “AI API 비용은 매달 얼마나 나올까?” 훗날 토큰 비용에 대한 부담감도 있었지만 GOOGLE API 사용하며 토큰 결제 어디선가… 데이터는 본인들의 시스템 개선을 위해 사용되어진다는 자그마한 문구를 본적이 있었고, 더욱더 CLOUD LLM 에 대해서 데이터의 안정성에 최고의 기술력을 가진 선두기업이니 잘할꺼야? 라고 무작정 믿기만 할순 없단 생각도 들었습니다.
엔지니어에게 설계 전 단계의 방향 설정은 전체 프로젝트의 절반 이상을 좌우한다. 코드를 한 줄이라도 작성하기 전에, 인프라 환경과 자동화 엔진, 그리고 LLM API 비용 전략을 먼저 정리해 두기로 했다.
1. 실행 환경 고민: 개인 PC vs NAS(Docker), 그리고 보안
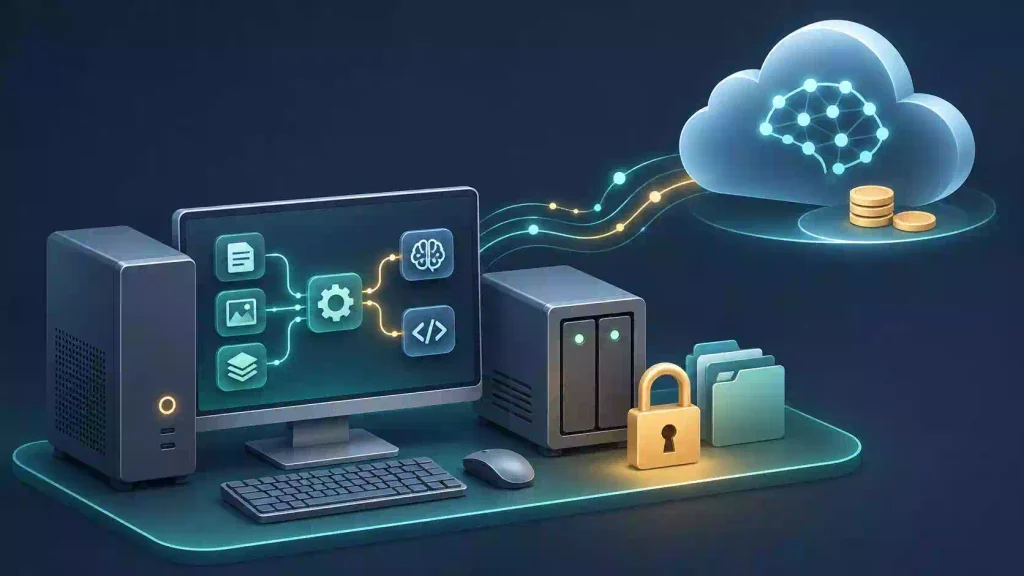
전장설계 현장에서 다루는 공정 일정표나 기술지원 현황 데이터는 외부에 함부로 유출되어서는 안 되는 민감한 업무 자료다. 따라서 처음부터 데이터는 로컬(내부망)에 머무르고, 필요한 연산이나 요약 요청만 최소한으로 처리하는 구조를 최우선 원칙으로 삼았다.
로컬에 자동화 서버를 구축할 때 가장 먼저 떠오른 선택지는 두 가지였다. 업무용 로컬 PC에 직접 구동하는 방식과, 시놀로지(Synology) 같은 NAS 장비에 Docker 컨테이너로 띄우는 방식이다.
- 로컬 PC 환경: 초기 세팅이 매우 빠르고, 로컬 드라이브에 저장된 엑셀 파일이나 도면 폴더에 직접 접근하기가 수월하다. 개발 초기 단계에서 코드를 수시로 수정하고 테스트하기에는 가장 쾌적하다. 다만 PC가 절전 모드에 들어가거나 퇴근 후 전원이 꺼지면 자동화가 멈춘다는 명확한 한계가 있다.
- NAS(Docker) 환경: 상시 운영에 유리하지만 실제 가용성은 네트워크와 전원, 백업 및 운영 환경에 달려 있다. 하지만 초기 네트워크 포트 설정이나 볼륨 마운트, 사내 문서 보안 환경과의 연동 테스트에는 추가적인 공수가 들어간다.
고민 끝에 단계적 이관 전략을 택했다. 초기 프로토타입과 핵심 워크플로우 검증 단계에서는 개발 속도가 가장 빠른 로컬 PC 환경에서 빠르게 구축하고, 구조가 안정화되면 추후 상시 가동 가능한 NAS나 사내 가상 서버(VM)로 이전하는 방향이다. 완벽한 인프라를 기다리느라 시작을 미루기보다, 당장 돌아가는 뼈대를 만드는 것이 실무 프로젝트에서는 훨씬 중요하다고 판단했다.
2. 왜 클라우드가 아닌 n8n 셀프호스팅인가
업무 자동화 도구는 Zapier, Make 등 훌륭한 클라우드 SaaS 서비스가 많다. 그럼에도 불구하고 최종적으로 n8n의 셀프호스팅(Self-hosted) 버전을 선택한 이유는 명확했다.
첫째는 비용과 실행 횟수 제한이다. 클라우드 기반 자동화 툴은 워크플로우가 한 번 실행될 때마다 과금되거나 월간 작업(Operation) 횟수 제한이 걸려 있다. 전장설계 공정 데이터는 수시로 갱신되고, 향후 대화형 챗봇 형태로 팀원들이 수시로 질의하게 될 텐데 실행 횟수를 신경 쓰면서 설계하는 것은 큰 제약이었다. 반면 n8n 셀프호스팅은 공정 코드 라이선스(Sustainable Use License) 정책상 개인 및 사내 내부 업무 자동화 용도로 사용할 때 워크플로우 수나 실행 횟수 제한 없이 무료로 운영할 수 있다.
둘째는 코드 수준의 확장성이다. 단순한 앱 간 연결을 넘어, 엑셀의 복잡한 조건 분기나 날짜 정제, 나아가 추후 도면 분석이나 데이터베이스 연동까지 확장하려면 노코드(No-Code)만으로는 한계가 온다. n8n은 시각적인 노드 흐름을 유지하면서도 필요한 지점에 JavaScript나 Python 코드를 자유롭게 끼워 넣을 수 있어, 엔지니어가 원하는 정밀한 로직을 구현하기에 최적이었다.
3. LLM API 선택과 비용 전략: ChatGPT vs Gemini
자동화 뼈대를 n8n으로 정했다면, 다음은 EVA의 ‘두뇌’ 역할을 할 LLM API를 고를 차례였다. 대표적으로 검토한 후보는 OpenAI의 ChatGPT API와 Google의 Gemini API였다. 두 모델을 비교할 때 나는 세 가지 기준을 세웠다.
- 초기 테스트 비용 부담이 적을 것: 프로토타입을 만들 때는 하루에도 수십 번씩 프롬프트를 고치고 에러를 잡으며 테스트를 돌려야 한다. 개발 단계에서부터 과금 걱정이 앞서면 실험 자체가 위축된다.
- 컨텍스트(문맥) 처리 능력과 응답 속도: 설계 공정 리스트나 기술지원 미결 목록처럼 표 형태의 정형 데이터를 읽고 빠르게 요약·분류해야 하므로, 긴 입력을 안정적으로 처리하면서도 응답이 빠른 경량 모델이 유리했다.
- 도구 호출(Tool Calling) 호환성: n8n의 AI Agent 노드와 연결해 캘린더 등록, 데이터 조회 같은 외부 도구를 정확하게 호출할 수 있어야 했다.
검토 결과, 초기 메인 엔진으로 Google Gemini API(Flash 계열 모델)를 채택했다. 무료 티어와 유료 전환 시의 토큰 단가가 매우 합리적이었고, 긴 텍스트 컨텍스트를 처리하는 효율이 뛰어나 표 데이터를 다루는 업무 비서에 잘 맞았기 때문이다.
무엇보다 중요하게 세운 비용 원칙은 “단순 계산과 필터링은 절대 LLM에게 시키지 않는다”는 것이었다. 날짜 차이(D-Day) 계산이나 담당자별 미결 건수 집계처럼 규칙이 명확한 연산은 n8n 내부의 JavaScript 코드 노드에서 LLM 호출 없이 처리하고, LLM은 오직 자연어 의도 파악과 최종 브리핑 생성에만 투입하도록 역할을 엄격히 나눴다.
4. 처음부터 ‘모듈형 구조’로 방향을 잡은 이유
첫 설계를 하면서 가장 경계한 것은 “모든 기능을 거대한 워크플로우 하나에 다 때려 넣는 것”이었다. 처음에는 편해 보여도, 나중에 기능이 하나씩 늘어나면 어디서 에러가 났는지 찾기 어렵고 유지보수가 불가능해진다.
그래서 기획 초기부터 EVA를 아래와 같은 독립된 모듈 단위로 쪼개어 설계하기로 방향을 잡았다.
- 데이터 수집·정제 모듈: 엑셀 등 원본 데이터에서 필요한 필드만 추출하고 표준화하는 계층
- 비즈니스 로직 모듈: AS·영업(TP) 미결건 분류, 3대 도면(Wiring·Connection·회로도) 마감 추적 등 실무 규칙을 처리하는 계층
- 인터페이스·알림 모듈: 추후 웹 채팅 UI, 캘린더, 사내 메신저 등 사용자와 만나는 접점 계층
- AI 추론 모듈: 필요에 따라 Gemini API에서 사내 로컬 LLM(Ollama 등)으로 언제든 교체할 수 있는 독립 계층
이렇게 계층을 분리해 두면, 나중에 엑셀 대신 사내 DB를 붙이거나 외부 API 대신 로컬 AI 모델로 전환하더라도 전체를 뜯어고치지 않고 해당 블록만 교체할 수 있다.
개발 단계에서 남긴 확인 사항: API 요금과 사용 한도는 개발 당시의 선택 기준이며, 실제 사용 시 공급자의 최신 정책을 확인해야 한다. 셀프호스팅도 서버·전력·유지보수 비용이 발생한다.
마치며
돌아보면 Day 02의 핵심은 화려한 기술을 도입하는 것이 아니라 ‘우리 현장 조건에 맞는 지속 가능한 구조’를 정하는 과정이었다. 로컬 PC에서 빠르게 시작하되 추후 서버 이전을 열어두고, n8n 셀프호스팅으로 비용 장벽을 없애며, 코드 연산과 AI 추론의 역할을 명확히 분리하는 것. 이 네 가지 원칙은 이후 두 달 넘게 EVA를 고도화하는 동안 흔들리지 않는 기준점이 되어 주었다.
이제 인프라와 설계 원칙은 모두 정해졌다. 다음 Day 03에서는 본격적으로 기존에 쓰던 엑셀 VBA 수작업 집계 로직을 n8n으로 이식하면서 겪은 데이터 정제 과정과 첫 번째 기술 장벽(로컬 파일 접근 권한 오류) 해결기를 다뤄보겠다.
